Une femme IA est une image synthétique produite par un modèle texte-vers-image à partir d’une description écrite. Aucun artiste ne la dessine. Un système de diffusion — entraîné sur des centaines de millions de photographies, d’illustrations et de peintures légendées — associe les mots d’un prompt à une distribution statistique de motifs visuels, puis calcule une nouvelle image qui leur correspond. Le résultat ressemble à un portrait parce que les données d’entraînement regorgeaient de portraits. Il correspond à votre description parce que le modèle a appris quels traits visuels sont associés à quels mots.
Voilà tout le mécanisme. Le reste — réalisme, diversité des styles, anomalies anatomiques occasionnelles, traitement différent des termes « anime » et « photoréaliste » — en découle. Comprendre ce mécanisme prend environ cinq minutes et évite des heures de frustration à rédiger des prompts.
She doesn't need a manual. Start talking and she'll figure out exactly what you like — your mood, your energy, your type. She adapts to you, not the other way around.
Ce que produit un générateur de femmes IA
Avant les résultats, clarifions une terminologie imprécise. « AI woman », « AI girl », « AI female » et leurs variantes désignent la même catégorie : un générateur texte-vers-image ou image-vers-image produisant des portraits synthétiques de femmes adultes. Certains sont généralistes et réussissent aussi les portraits. D’autres sont spécifiquement affinés pour représenter des humains photoréalistes. Les résultats vont du photoréalisme à l’aquarelle en passant par l’anime. L’architecture du modèle est identique ; les données d’entraînement et les ajustements ultérieurs déterminent l’orientation du résultat.
- Ce que c’est : Un système qui lit un prompt, le traite dans un réseau de neurones et produit un fichier image. La « femme » n’est stockée nulle part : elle est recalculée à chaque fois à partir de bruit, guidée par le prompt et les poids appris du modèle.
- Ce que ce n’est pas : Une base de données de personnes réelles, un logiciel de retouche ou un système qui « imagine » au sens véritable. Il reconnaît des motifs. Le caractère humain du résultat tient aux données d’entraînement, pas à des préférences ou à une conception de la beauté du modèle.
- Ce que vous contrôlez : Le prompt, les modificateurs de style, le format d’image et, sur la plupart des plateformes, une graine permettant de reproduire les résultats. Vous ne contrôlez pas le résultat exact : les générateurs sont stochastiques. Deux prompts identiques produisent des images différentes.
Repères rapides: Quel réglage change quoi?
| Ce que vous voulez modifier | Comment le modifier |
| Style visuel global (photo, anime ou illustration) | Mot-clé de style dans le prompt ou sélecteur dédié |
| Traits du visage, cheveux, vêtements | Termes descriptifs : le précis vaut mieux que le jugement esthétique |
| Éclairage et ambiance | Termes d’éclairage (« lumière douce d’une fenêtre », « heure dorée ») |
| Composition | Termes de cadrage (« portrait en gros plan », « en pied », « cadrage à la taille ») |
| Cohérence entre plusieurs images | Graine ; certaines plateformes proposent un verrouillage du personnage |
| Résolution et format | Paramètres du modèle, pas le prompt |
Le style compte plus que toute autre variable. Un mode réaliste accompagné d’un prompt faible paraît plus photographique qu’un mode anime accompagné d’un prompt solide, quels que soient les mots employés.
Choisissez votre femme IA idéale
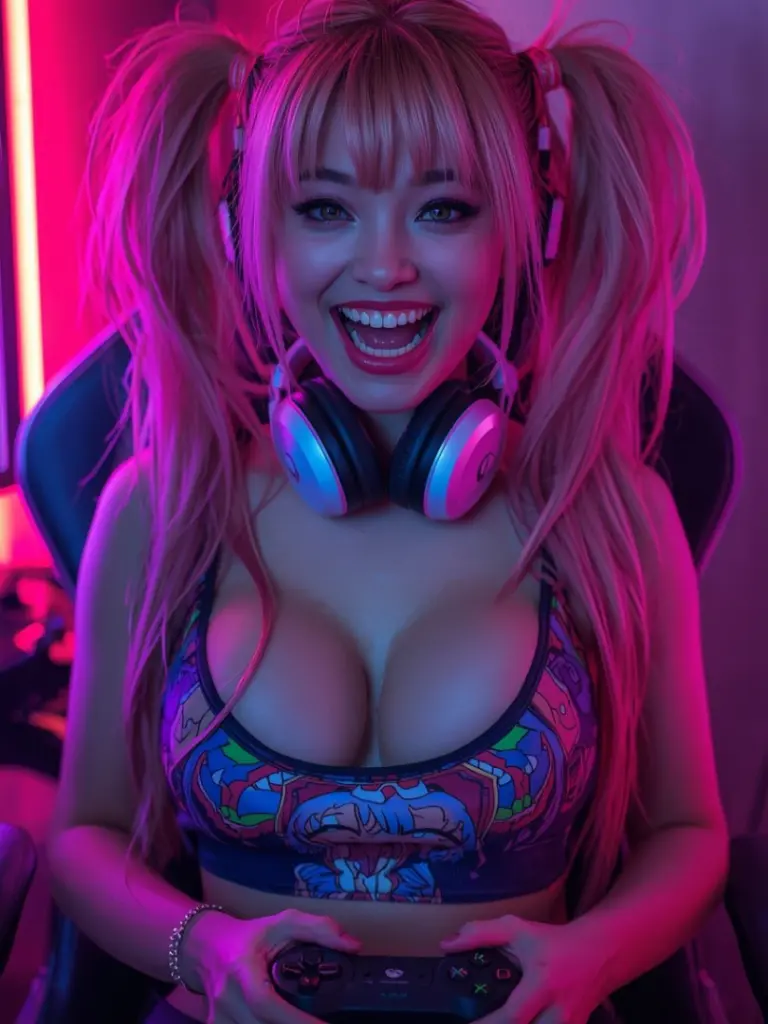
Loud, funny, and obsessed with gaming. Akira will wreck you in any game and then send… Loud, funny, and obsessed with gaming. Akira will wreck you in any game and then send you a cute apology message — before doing it again. Endearingly chaotic energy.
Loud, charismatic, and secretly vulnerable. She pulls people in and never lets conver… Loud, charismatic, and secretly vulnerable. She pulls people in and never lets conversations stay boring.
Cold, efficient, and intensely attractive. She operates in moral grey zones and makes… Cold, efficient, and intensely attractive. She operates in moral grey zones and makes every conversation feel like a mission.
Vrai ou faux: Les idées reçues fréquentes
Les malentendus s’accumulent vite dans cette catégorie, en partie parce que les résultats paraissent si convaincants, en partie parce que le marketing exagère souvent les capacités du modèle. Voici ceux à dissiper avant de consacrer du temps aux prompts.
«Le modèle possède une idée par défaut de ce qu’il trouve beau»
En quelque sorte, mais pas comme on l’imagine. Un modèle de diffusion n’a pas de préférences. Il a appris des corrélations. Si certaines structures faciales ou morphologies étaient surreprésentées dans les images associées à des qualificatifs positifs, ces motifs deviennent la norme statistique. Le biais provient des données, pas d’une opinion esthétique du modèle. Un prompt précis permet de contrer ces tendances : elles ne sont pas immuables.
Les bons prompts sont courts, pas longs
On suppose souvent qu’un prompt plus long produit une meilleure image. La longueur n’aide que jusqu’à un certain point. Au-delà, l’attention du modèle se répartit entre tous les tokens et se dilue. Un prompt de 40 mots avec une hiérarchie claire — sujet, puis style, puis éclairage — surpasse régulièrement une liste de 120 mots d’attributs. Privilégiez l’ordre et la clarté plutôt que la quantité.
« L’IA se souvient des personnages d’une session à l’autre »
La plupart des générateurs ne le font pas. Chaque image est une inférence distincte issue du prompt et de la graine, sans référence à un résultat antérieur. La cohérence d’un personnage entre plusieurs images exige soit une graine verrouillée — le même point de départ du bruit — soit une fonction dédiée, proposée par certaines plateformes mais absente de beaucoup d’autres. Partez du principe qu’il n’y a pas de mémoire, sauf indication explicite.
« Les images d’IA sont toujours reconnaissables »
C’était vrai en 2022. Les modèles photoréalistes actuels produisent régulièrement des images qui passent un examen superficiel. L’anatomie des mains, la cohérence des arrière-plans, le texte dans l’image et les détails des oreilles restent des indices révélateurs, mais progressent vite. Plus la scène est maîtrisée, plus il est difficile de distinguer le résultat d’une photographie.
«Il faut un talent artistique pour obtenir de bons résultats»
Il faut savoir rédiger des prompts, ce qui est une autre compétence. Comprendre les interactions entre mots-clés de style, modificateurs et modèle s’apprend en quelques heures d’essais. Le savoir-faire consiste à savoir quoi demander ; l’exécution est automatisée.
«Cela ne sert qu’aux projets créatifs»
Les usages sont plus larges qu’on ne le pense :
- Images de profil et avatars sans photographies réelles
- Concepts de personnages pour jeux vidéo, fiction et jeux de rôle sur table
- Références visuelles pour les auteurs qui ont besoin d’un visage pour leur personnage
- Création rapide de contenus sociaux et éditoriaux
- Maquettes de produits et recherches de mode avant une séance photo
- Références pour storyboards et direction artistique
Les générateurs se sont implantés dans le développement de jeux, le design de marque et la création de contenus en solo parce que les résultats arrivent en secondes, non en heures. Le projet créatif est l’usage le plus visible, pas le plus courant.
La mémoire des générateurs: Session, verrouillage du personnage et cohérence
La plupart des générateurs texte-vers-image n’ont aucune notion d’état de session. Chaque image est une création nouvelle. En produisant la suivante, le modèle ignore qu’il en a déjà produit une.
Pourquoi les personnages changent
La graine contrôle le motif de bruit initial. Deux images ayant la même graine et le même prompt sont identiques. Avec le même prompt mais des graines différentes, elles partagent les attributs décrits — couleur des cheveux, traits indiqués —, mais la géométrie faciale varie. Le modèle ne conserve aucune « identité » du personnage. Il recrée les traits à partir du prompt à chaque fois.
Verrouillage du personnage et affinage
Certaines plateformes y remédient en intégrant une image de référence au processus, puis en contraignant les résultats suivants à lui correspondre.
La technique fonctionne mieux pour le style et les grands traits que pour les détails fins du visage. Un modèle dédié, affiné sur l’apparence d’un personnage précis — par un procédé appelé inversion textuelle ou entraînement LoRA — offre une cohérence supérieure, mais demande davantage de préparation et n’est pas disponible partout.
Ce que signifie ici « mémoire à long terme »
Dans les applications de compagnonnage combinant conversation et images, la « mémoire » désigne un profil de personnage stocké entre les sessions. C’est une couche applicative distincte, pas le modèle d’image lui-même. Le modèle visuel génère chaque image à neuf ; l’architecture de l’application lui retransmet la description du personnage. Cette distinction compte pour évaluer les promesses de mémoire : concernent-elles la conversation, l’image ou les deux ?
Bien débuter
L’apprentissage du texte-vers-image se concentre au départ. L’essentiel devient clair dès les premières séances. Voici ce qui distingue une première heure frustrante d’une heure productive.
Femme anime, réaliste ou cinématographique: Le style d’abord
Choisir le style avant tout facilite chaque décision ultérieure. Les styles — photoréalisme, peinture numérique, anime, illustration, cinéma — ne sont pas de simples choix esthétiques. Ils influencent les détails bien rendus, la précision anatomique attendue et les termes efficaces dans les prompts.
La haute résolution dépend souvent aussi du style : certaines plateformes produisent des fichiers plus grands en mode photoréaliste qu’en anime. Fixez d’abord le style, puis adaptez le reste.
Le sujet avant les attributs
Les modèles traitent les prompts approximativement de gauche à droite. Plus un terme est proche du début, plus il pèse.
Commencez par le sujet (« portrait d’une femme »), puis les attributs essentiels (cheveux, vêtements, décor), puis les modificateurs (éclairage, ambiance, angle). Évitez de commencer par « belle » ou « magnifique » : ces appréciations consomment du poids sans donner d’instructions visuelles précises.
Utilisez des prompts négatifs
La plupart des générateurs acceptent une liste d’éléments à exclure. Exemples courants pour commencer :
- mains déformées ou doigts supplémentaires
- arrière-plan flou ou flou de mouvement
- filigrane ou texte intégré
- faible résolution ou résultat pixellisé
Un prompt négatif simple améliore presque chaque génération. Préparez-en un et réutilisez-le.
Conservez les graines efficaces
Lorsqu’une image réussit — bonne structure du visage, bonne impression —, notez sa graine. Vous pourrez revenir à ce point de départ avec des prompts ajustés et faire évoluer une base satisfaisante au lieu de repartir de zéro.
Accès gratuit ou offres payantes : Prévoyez votre budget
Tous les générateurs sont stochastiques. Vous produirez des images à jeter. Les plateformes facturant en crédits ou tokens rendent cette consommation visible ; celles proposant l’illimité la rendent invisible, en contrepartie d’une vitesse et de délais d’attente moins favorables.
Prévoyez 5 à 10 générations pour trouver un prompt donnant de bons résultats régulièrement. Budgétez les essais, pas une seule image. Les plateformes de ce site facturent différemment : quota mensuel pour certaines, paiement par résultat pour d’autres. Vérifiez avant de souscrire.
Commencez par discuter, ajoutez les médias ensuite
Sur les plateformes combinant chat et images, la conversation détermine si l’expérience vous convient et coûte le moins cher. Testez-la sans dépenser de tokens multimédias. Si l’interaction tient après quelques séances, la question des images devient un choix budgétaire plutôt qu’un engagement initial.
Pourquoi utiliser un générateur de femmes IA ?
Les motivations exprimées se répartissent en catégories distinctes, irréductibles les unes aux autres.
- Références créatives. Auteurs, concepteurs de jeux et illustrateurs utilisent les portraits comme références : un visage pour écrire, un concept à faire évoluer, une pose qui prendrait des heures à photographier ou commander. La vitesse compte plus que la perfection.
- Images sociales et de profil. Avatars et portraits générés évitent les photographies réelles. Pour qui ne souhaite pas diffuser ses photos personnelles, un portrait IA stylisé ou réaliste est une alternative pratique.
- Production visuelle. Les créateurs pour réseaux sociaux, newsletters et médias éditoriaux y voient une solution plus rapide et économique pour obtenir des images originales que les banques d’images ou l’illustration sur commande. Le résultat est propre au prompt, non une image de stock sous licence.
- Plateformes de personnages. Une part importante de l’écosystème alimente des applications où l’image est associée à un personnage de chat : une femme IA dont l’apparence vient du générateur et la conversation d’un modèle de langage. L’image n’est pas le produit, mais la couche visuelle d’une application interactive plus vaste. L’économie diffère — généralement abonnement et tokens multimédias —, tout comme les attentes.
- Exploration. Certains utilisateurs expérimentent simplement. Les résultats sont nouveaux et la boucle de retour rapide. C’est une raison suffisante.
Ces motifs déterminent les fonctionnalités utiles. Un auteur privilégie la cohérence et les itérations rapides. Un créateur de contenus veut qualité et volume. Un utilisateur de plateforme de personnages recherche l’intégration entre modèle visuel et chat. L’outil adapté à l’un convient mal aux autres.
Les coûts réels selon l’usage
Le budget varie considérablement. Quelques portraits par semaine ne coûtent presque rien avec une offre payante. Produire quotidiennement images et vidéos relève d’un autre budget.
| Usage | Coût mensuel courant, septembre 2026 |
| Chat seul ou très peu d’images | Moins de 10 USD/mois avec facturation annuelle |
| Images régulières, quelques-unes par jour | 15–25 USD/mois, abonnement compris |
| Images quotidiennes et voix ou vidéo occasionnelles | 25–45 USD/mois |
| Vidéo et voix quotidiennes, volume élevé | 40–60 USD/mois ou davantage |
Ce sont des fourchettes de la catégorie parmi les plateformes de ce site, pas les prix d’un produit donné. L’abonnement constitue le plancher ; le quota multimédia détermine la vitesse à laquelle vous atteignez le plafond.
Ce qu’AI Woman ne peut pas faire
Cette section mérite d’être lue avant tout, car les promesses dépassent largement la réalité technologique.
Reproduire fidèlement le même visage sans verrouillage du personnage
Sans mécanisme de verrouillage facial, un modèle texte-vers-image standard produit une géométrie différente à chaque génération, même avec le même prompt.
« Pommettes hautes » ou « yeux bleus » délimitent une distribution, pas un visage. Si l’identité constante compte, vérifiez la présence d’une fonction dédiée avant de vous engager.
Suivre correctement des compositions complexes
« Debout près d’une fenêtre, regardant par-dessus son épaule gauche, une main levée » est une composition que les générateurs traitent de manière irrégulière.
Ils maîtrisent mieux le style global et les attributs que les relations spatiales entre éléments. Attendez-vous à multiplier les essais pour des compositions complexes.
Produire actuellement du texte fiable dans les images
Les lettres sont fréquentes dans les données, mais leur sens n’est pas compris par le modèle. Il en résulte des formes textuelles plausibles visuellement, mais incohérentes linguistiquement. Le texte lisible doit être ajouté en postproduction.
La vidéo reste moins avancée que l’image fixe
Quand des plateformes proposent des clips de personnages générés, l’écart de qualité avec les images est important. Les mouvements sont courts, parfois saccadés et sujets à des variations d’identité d’une image à l’autre.
La technologie progresse, mais « vidéo » ne signifie pas ici ce qu’il signifie dans une production professionnelle.
Le résultat est une image, pas une relation
Il faut le dire clairement à propos des applications de personnages : le modèle visuel produit une ressource graphique. Le sentiment de relation, s’il se développe, provient du modèle de langage et de l’interprétation de l’utilisateur.
L’image n’est pas une personne et n’accumule pas d’expérience. Les bonnes applications le comprennent et le prennent honnêtement en compte. Les mauvaises survendent une continuité que la technologie ne permet pas encore pleinement.
Générateurs de femmes IA et outils voisins
Les frontières comptent, car des outils différents sont commercialisés sous des descriptions proches.
| Type d’outil | Ce qu’il fait | Ce qu’il ne fait pas |
| Générateur texte-vers-image | Crée une image à partir d’un prompt | Préserver l’identité entre sessions, généralement |
| Plateforme de personnages IA | Combine chat et génération d’images | Fonctionner comme outil visuel autonome ; les résultats sont liés au personnage |
| Éditeur d’images avec IA | Modifie une photographie importée | Générer à partir de rien ; il part d’une image réelle |
| Générateur d’anime ou d’avatars | Produit un portrait stylisé depuis une photo ou un prompt | Produire du photoréalisme ; il vise une esthétique spécifique |
| Outil d’échange de visages | Remplace un visage dans une image existante | Générer des images originales ; il exige un matériau source |
Un générateur généraliste offre le maximum de contrôle et le minimum de structure. Une plateforme de personnages offre une expérience intégrée et moins de contrôle visuel. Un générateur d’avatars fournit le résultat le plus rapide dans un style fixe. Connaître la catégorie aide à ajuster les attentes avant de payer.
Générateur AI Girl ou plateforme de personnages: Pourquoi distinguer les deux ?
Les recherches « ai woman generator » ou « ai girl generator » mènent souvent vers des plateformes de personnages plutôt que des outils autonomes, parce que ces plateformes dominent les résultats. Ce n’est pas le même produit.
Une plateforme limite le contrôle des images à ce qui convient à son système de personnages ; un générateur indépendant offre davantage de liberté de prompt, mais aucune conversation. Aucun n’est mauvais : ils répondent à des besoins différents. Le terme de recherche couvre les deux ; votre choix doit correspondre à votre objectif.
Pour un portrait réaliste de profil ou une référence créative, commencez par un générateur texte-vers-image. Pour un personnage récurrent doté d’un nom, d’une personnalité et d’une mémoire de vos échanges, choisissez une plateforme de personnages.
La plupart des déceptions viennent de leur confusion. Plusieurs plateformes de ce site combinent toutefois les deux : vous pouvez générer des images et discuter avec le même personnage. Leur qualité sur chaque volet est une autre question que l’existence de cette distinction.
Le débat: Ce que disent les critiques et ce qui est justifié
Les critiques portent sur plusieurs points, qui ne se valent pas tous.
La question des données d’entraînement
Les modèles de diffusion utilisent de vastes jeux de données collectés sur internet. Le consentement des personnes dont les photographies y figurent est contesté, juridiquement dans plusieurs pays et éthiquement dans une discussion plus large.
C’est un problème réel, non marginal, qui concerne la plupart des grands modèles actuels. Le droit évolue encore : en 2026, des procédures sont en cours dans plusieurs pays, sans issue définitivement établie.
Représentation et biais par défaut
Le modèle reflète la distribution de ses données. Si certaines morphologies sont surreprésentées, elles deviennent le résultat par défaut.
Les critiques estiment que cela encode et amplifie des biais existants ; les défenseurs répondent que les prompts peuvent les contourner. Les deux sont vrais. Le biais est réel et partiellement corrigeable par l’utilisateur. La question essentielle — l’importance des valeurs par défaut même lorsqu’elles sont corrigeables — n’a pas de réponse simple.
Des usages qui ne sont pas neutres
Le générateur servant aux concepts de personnages produit aussi des contenus que certains utiliseront d’une façon jugée répréhensible par d’autres. Les plateformes appliquent des filtres plus ou moins stricts. Ceux-ci sont imparfaits et la discussion sur leurs limites est bien réelle et toujours ouverte.
Cette page ne peut trancher, mais utiliser un générateur de femmes IA implique une technologie dont les applications sont réellement contestées, pas simplement mal comprises.
Là où les critiques se trompent
L’approche médiatique la moins utile traite les résultats comme des photographies de personnes réelles. Ce n’en sont pas.
Un modèle de diffusion n’extrait ni ne transforme les images d’individus précis, sauf exceptions limitées de modèles affinés sur des personnes spécifiques, une catégorie différente et éthiquement plus complexe. Le réalisme rend cette distinction difficile à saisir intuitivement.
Le mécanisme est essentiel: le modèle génère à partir de motifs statistiques appris, non d’images sources stockées. Cela compte pour évaluer les critiques et comprendre ce qu’il fait réellement lorsqu’il produit une image ressemblant à une personne réelle.
Frequently Asked Questions
Que fait réellement un modèle texte-vers-image ?
Il associe une description à un point d’un espace de probabilités visuelles appris, puis calcule une image. Entraîné sur des paires image-texte, il apprend quels motifs correspondent à quels mots. Lors de la génération, il part d’un bruit aléatoire et l’affine progressivement vers une image conforme au prompt. La « femme » n’est ni dessinée ni sélectionnée : elle est calculée.
Pourquoi les mains restent-elles incorrectes ?
Leur anatomie est complexe et les données montrent une immense variété d’angles, de parties cachées, de tailles et de positions. Le modèle apprend leur apparence globale, sans comprendre la structure du squelette. Il produit une forme plausible plutôt qu’une main anatomiquement correcte. Certains modèles récents progressent, mais cela reste un point faible connu.
Peut-il produire le même personnage dans plusieurs images ?
Pas de manière fiable avec un prompt seul. La graine conserve le motif de bruit initial, ce qui aide sans garantir l’identité faciale. Certaines plateformes utilisent une référence visuelle pour contraindre les générations suivantes. La cohérence s’améliore, sans être parfaite.
L’utilisation est-elle payante ?
Cela varie. Les accès gratuits sont généralement limités à quelques images par jour ou par compte. En septembre 2026, les offres payantes se situent globalement entre 14 et 20 USD/mois en paiement mensuel, ou entre 4 et 10 USD/mois avec règlement annuel anticipé. Images, voix et vidéo consomment un quota; les utilisateurs multimédias actifs dépensent généralement 15 à 60 USD/mois selon le volume.
Quelle différence entre générateur de femmes IA et plateforme de personnages ?
Le générateur autonome produit des images à partir de prompts, puis s’arrête là. La plateforme relie un modèle de conversation et un modèle d’image grâce à une définition persistante du personnage. L’image représente alors un personnage conversationnel, plutôt qu’un résultat indépendant. La génération visuelle fonctionne de la même manière ; la couche applicative est entièrement différente.
Quels styles sont généralement proposés ?
La plupart des plateformes actuelles proposent au minimum un mode photoréaliste et un mode anime ou stylisé. D’autres ajoutent cinéma, art, fantasy et diverses catégories. Le style se choisit généralement dans un menu ou par étiquette, même si sa définition dans le prompt fonctionne aussi sur la plupart des modèles.
La plateforme voit-elle ou stocke-t-elle mes images ?
Oui, généralement. Elles transitent par ses serveurs ; la plupart des conditions prévoient un stockage au moins temporaire. Certaines plateformes les conservent indéfiniment, quelques-unes offrent des outils de suppression. Consultez la politique de confidentialité avant de générer du contenu privé. Le chiffrement de bout en bout des médias générés n’est pas habituel dans cette catégorie.
Les résultats sont-ils utilisables commercialement ?
Cela dépend des conditions d’utilisation. Beaucoup de plateformes accordent de larges droits commerciaux pour les résultats des offres payantes ; certaines réservent des droits ou exigent une attribution. Un petit nombre interdit totalement l’usage commercial. Vérifiez les conditions précises avant toute utilisation professionnelle d’images générées.